Plus rapide
De quelques minutes à quelques millisecondes pour une tâche que la flotte répète sans cesse.
Preuves tirées de cas réels
Une flotte Constelio commence par raisonner avec un modèle de langage. Quand une tâche revient régulièrement, le méta-agent transforme ce qui fonctionne en code simple. Voici des mesures issues de nos propres flottes, telles qu'elles ont été enregistrées.
Cas 01
Un agent collecteur rassemble l'état de cinq machines en interrogeant l'agent présent sur chacune. Même tâche, même flotte, à quelques heures d'intervalle.
| Metric | Avant | Après |
|---|---|---|
| Durée | 6 min 42 s | 909 ms |
| Tokens en entrée | 100 460 | 0 |
| Tokens en sortie | 2 408 | 0 |
≈ 440× plus rapide
et plus aucun coût de modèle de langage
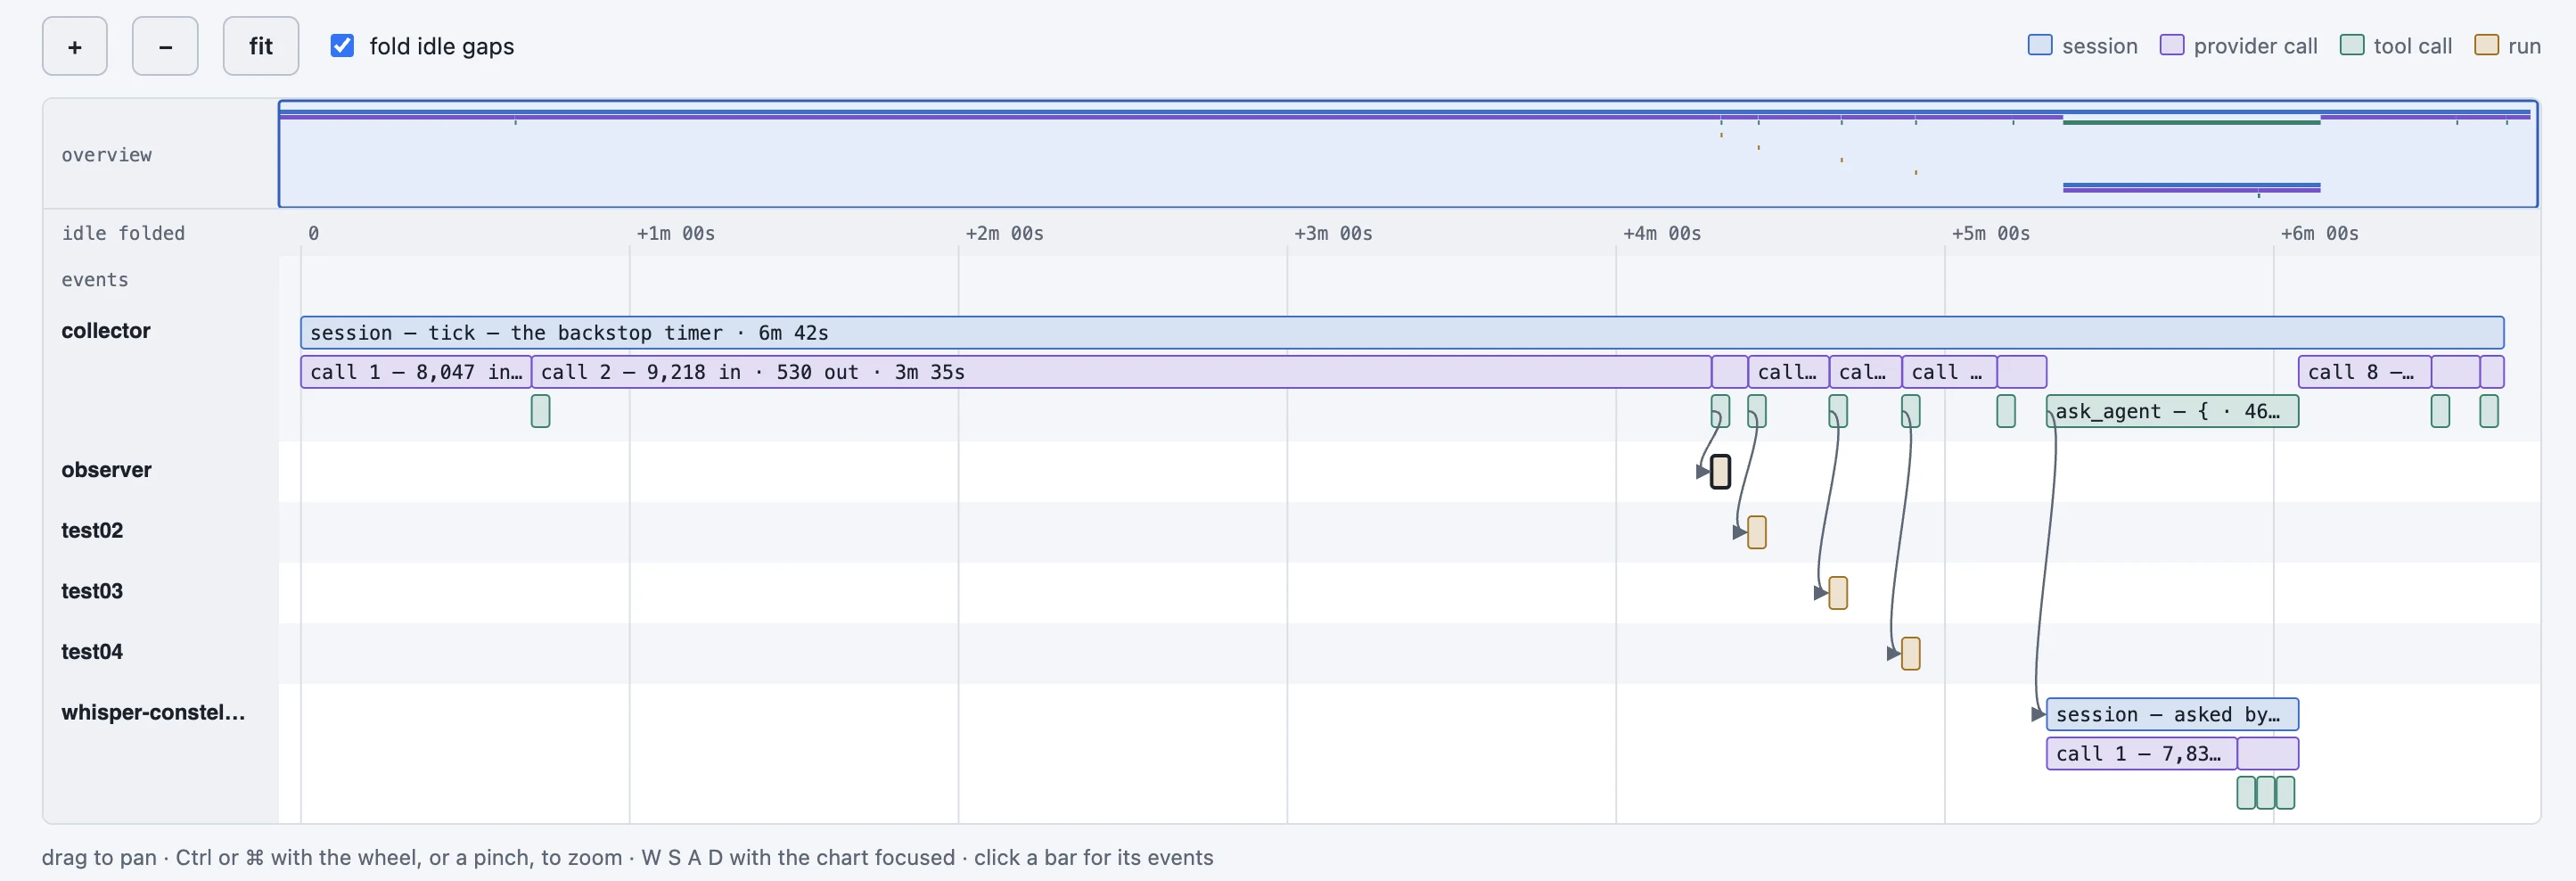
Le collecteur utilise son modèle de langage pour planifier la tâche, interroger chaque agent tour à tour et assembler la réponse. Cela fonctionne, mais c'est lent et consomme des tokens à chaque fois.
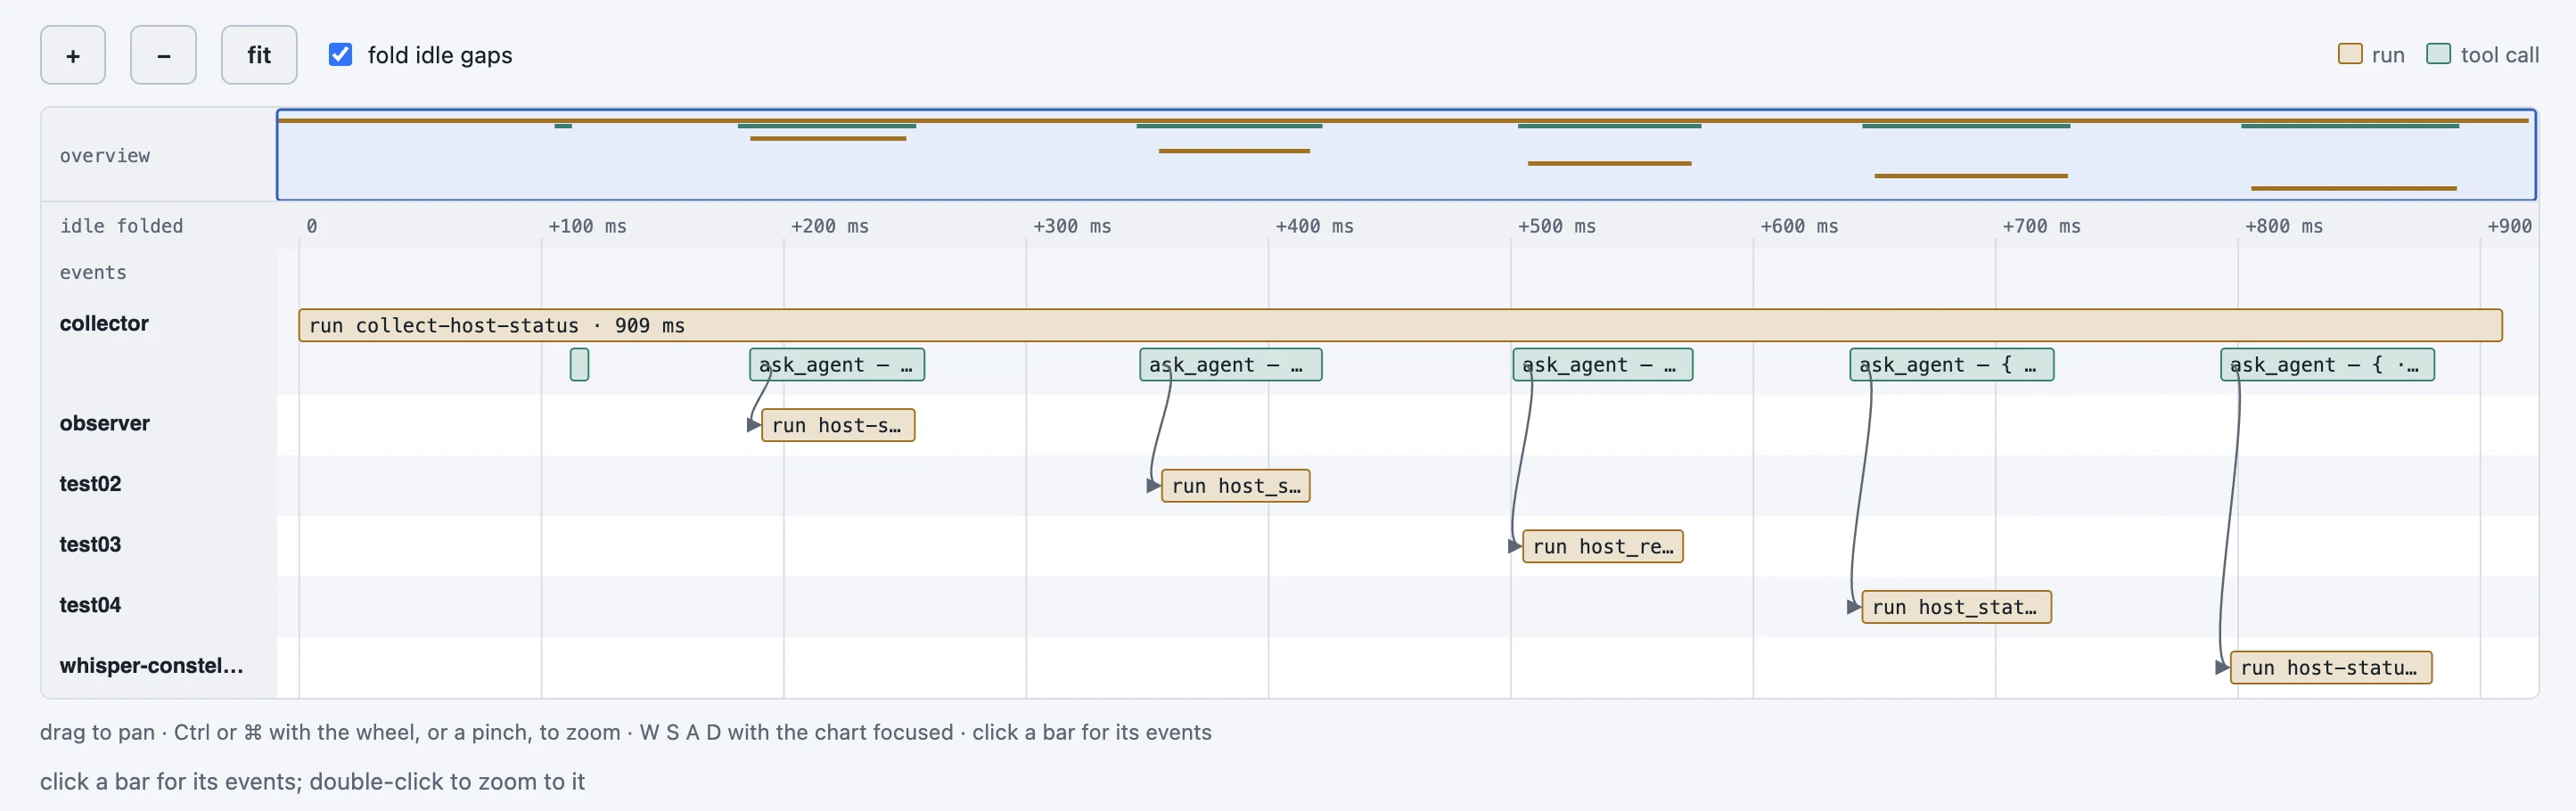
Le schéma récurrent est devenu une exécution déterministe, collect-host-status. Les mêmes cinq agents sont interrogés, par du code simple, sans aucun modèle de langage.
Extrait du traçage des appels
De quelques minutes à quelques millisecondes pour une tâche que la flotte répète sans cesse.
Zéro token : aucun coût d'inférence et aucun temps GPU pour le travail de routine.
Les mêmes étapes à chaque fois, et chaque appel reste enregistré : les deux chronologies proviennent du traçage des appels de la flotte.
D'autres cas viendront s'ajouter ici à mesure que nos flottes apprennent.